美国大学研究:ChatGPT 的新闻搜索结果经常不准确

seekdeep2年前AI资讯816

据 The Verge 北京时间今日报道,美国哥伦比亚大学 Tow 数字新闻研究中心(Tow Center for Digital Journalism)的研究人员测试发现,OpenAI 的 ChatGPT 搜索工具在准确性上存在一些问题。

今年 11 月,OpenAI 面向订阅用户推出了这一工具,称其可以快速提供答案,并附带相关网页来源链接。然而研究显示,ChatGPT 搜索在识别文章引用时表现不佳,即使是面对来自与 OpenAI 数据共享的出版商的内容,ChatGPT 也难以准确处理。

研究人员测试了 20 家出版商的 200 条引文,其中 40 条来自禁止 OpenAI 爬虫抓取的网站。但 ChatGPT 依然自信地给出了错误答案,几乎没有表明自身的不确定性。
d50735fae6cd7b894bfb3455c3974aa8db330e97.jpg

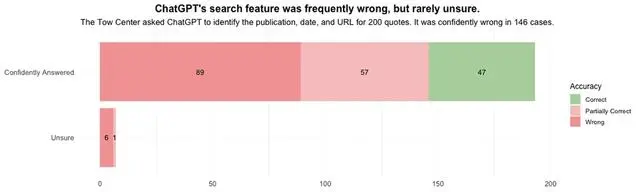
测试结果显示,ChatGPT 的 153 次回答完全或部分错误,仅有 7 次明确表示无法准确回答。这 7 次回答中,它使用了“看起来”“有可能”等限定词,或直接承认“无法找到具体文章”。

一份图表进一步显示,ChatGPT 的回答中“错误”的占 89 次,“部分正确”有 57 次,而完全“正确”的只有 47 次。

测试中还记录了一些典型案例,例如,ChatGPT 错误地将《奥兰多哨兵报》读者来信的引用归因为《时代周刊》文章;另一个例子中,它在被要求确认《纽约时报》一篇关于濒危鲸鱼的文章引用时,链接到了一家完全剽窃该文章的网站。

OpenAI 对《哥伦比亚新闻评论》回应称,“在缺乏 Tow Center 隐藏的测试数据和方法的情况下,解决错误归因非常困难。这次研究是对我们产品的非典型测试。”OpenAI 同时承诺将继续优化搜索结果。

据IT之家此前报道,今年早些时候,OpenAI 还宣布与新闻行业进行了广泛的合作,并收集了合作伙伴对于搜索功能的反馈。任何网站或出版商都可以选择出现在 ChatGPT 搜索结果中。达成合作的媒体和出版商包含美联社、阿克塞尔・斯普林格、康泰纳仕、道奇梅雷迪思、《金融时报》、GEDI、赫斯特、《世界报》、路透社、大西洋月刊、时代杂志和 Vox 媒体等等。
相关文章

争夺“中国ChatGPT”心智定位,零一万物首次出新To C 李开复再出马!

李开复表示,大模型推理成本的下降会推动中国AI大模型进入”落地为王”的阶段,今年会迎来“大模型应用爆发元年”。他同时预测,明年下半年,随着大模型推理成本的大幅度下降,人们将迎来大模型普惠应用的井喷期。...

OpenAI推出新旗舰模型GPT-4o,图文音频手机AI搞定,类人速度超快语音响应!

年初“文生视频模型”Sora后许久未给市场带来惊喜的OpenAI举行春季发布会。公司首席技术官米拉·穆拉蒂(Mira Murati)向外界展现了多项与ChatGPT有关的更新。简要来说,OpenAI的...

移除 Copilot Pro 的 GPT Builder 功能,微软将于 7 月进行!

日前微软方面宣布,自 2024 年 7 月 10 日起将移除 Copilot Pro 服务中的 GPT Builder 功能,即不再支持用户使用文档、外部或内部资源以及自定义指令创建自己的专属 Cop...

推出全新GPT+产品易智汇,易点云与微软AI产品展开全面合作!

  近日,易点云在AI领域迈出了坚实的步伐,携手全球技术巨擘和信诺时代,发布了针对中小企业设计的GPT+产品——“易智汇”。  这款产品不仅将AI技术的强大能力带给了中小企业,还以极具吸引力的价格和服...

为抵制AI侵权,全球80余家出版商结盟!

为抵制AI侵权,全球80余家出版商结盟!

据路透社报道,当地时间12日,《纽约时报》、法新社以及《经济学人》等40余家出版商加入一个联盟,旨在阻止人工智能企业未经许可使用其出版内容并从中获利。报道称,今年2月,这个名为出版商使用权标准联盟(S...

上海AI Lab开始给大模型重新出题了,GPT-4o数学能力跑分直掉50%!

新模型在 MATH 上(以数学竞赛为主)动辄跑分 80% 甚至 90% 以上,却一用就废。这合理吗??为了真实检验模型数学推理能力,上海人工智能实验室司南 OpenCompass 团队放大招了。推出新...