性能全面赶超GPT-4 Turbo,阿里云发布通义千问2.5!

seekdeep2年前AI资讯940

阿里云正式发布通义千问2.5,模型性能全面赶超GPT-4 Turbo,成为地表最强中文大模型。同时,通义千问最新开源的1100亿参数模型在多个基准测评收获最佳成绩,超越Meta的Llama-3-70B,成为开源领域最强大模型。


相比通义千问2.1版本,通义千问2.5的理解能力、逻辑推理、指令遵循、代码能力分别提升9%、16%、19%、10%,中文能力更是持续领先业界。在权威基准OpenCompass上,通义千问2.5得分追平GPT-4 Turbo,是该基准首次录得国产大模型取得如此出色的成绩。


通义还发布了最新款开源模型,1100亿参数的Qwen1.5-110B,该模型在MMLU、TheoremQA、GPQA等基准测评中超越了Meta的Llama-3-70B模型;在HuggingFace推出的开源大模型排行榜Open LLM Leaderboard上,Qwen1.5-110B冲上榜首,再度证明通义开源系列业界最强的竞争力。


通义的多模态模型和专有能力模型也具备业界顶尖影响力。通义千问视觉理解模型Qwen-VL-Max在多个多模态标准测试中超越Gemini Ultra和GPT-4V,目前已在多家企业落地应用;通义千问代码大模型CodeQwen1.5-7B则是HuggingFace代码模型榜单Big Code的头名选手,还是国内用户规模第一的智能编码助手通义灵码的底座。


通义大模型问世一年多来,还发展出了业界领先的文生图、智能编码、文档解析、音视频理解等能力,企业客户和开发者可以通过API调用、模型下载等方式接入通义,个人用户可从通义APP、官网和小程序免费使用通义家族全栈服务。
相关文章

周期压缩八成 效率以一当十,深圳无处不AI AI设计师卷到珠宝界!

2025年早春,深圳水贝国际珠宝交易中心一开工就热火朝天。晨曦中,商户们陆续走进工坊,设计师坐到电脑前,客户到访工作室……这座“珠宝之都”的繁忙景象看似与往年无异,但敏锐的从业者已然察觉,在科技创新浪...

上海AI Lab开始给大模型重新出题了,GPT-4o数学能力跑分直掉50%!

新模型在 MATH 上(以数学竞赛为主)动辄跑分 80% 甚至 90% 以上,却一用就废。这合理吗??为了真实检验模型数学推理能力,上海人工智能实验室司南 OpenCompass 团队放大招了。推出新...

为律师提供写作质效双保障,Alpha系统写作GPT 再升级!

随着行业的进一步发展,法律AI进入法律人的视野,不断刺激着律师工作方式的改变。法律AI的技术应用已成为大势所趋,学习如何用好AI工具,将成为每个法律人都要参与的新一轮竞争。AlphaGPT即是一款应时...

智启未来生活 AI赋能家电

智启未来生活 AI赋能家电

智能互联让生活更精彩  3月21日,在“未来家 让生活充满AI——2025AWE高峰论坛”上,中国家用电器协会执行理事长姜风指出,人工智能正以前所未有的速度在各行业落地生根,为人们生活和产业格局带来深...

美国专利商标局驳回了OpenAI申请"GPT"商标的尝试

美国专利商标局(U.S. Patent and Trademark Office)驳回了 OpenAI 申请"GPT"商标的尝试,裁定该词"仅仅是描述性的",因...

OpenAI总裁:人机合作还得加强!ChatGPT击败50名人类医生!疾病诊断准确率达90%。

OpenAI总裁:人机合作还得加强!ChatGPT击败50名人类医生!疾病诊断准确率达90%。

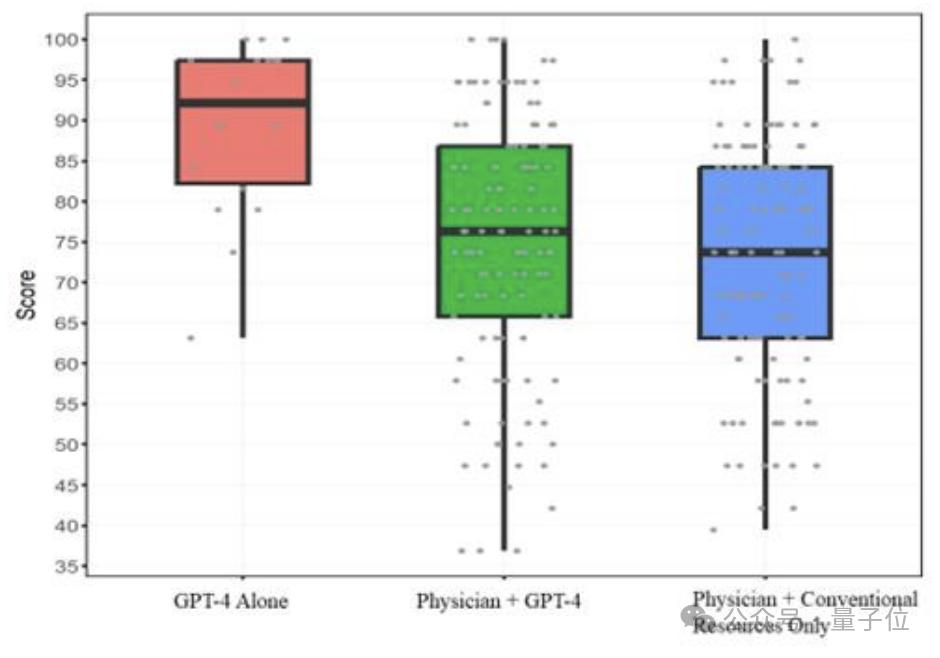
用ChatGPT诊断疾病,准确率已经超过了人类医生?!斯坦福大学等机构进行了一轮随机临床试验,结果人类医生单独做出诊断的准确率为74%。在ChatGPT的辅助之下,这一数字提升到了76%。有意思的是,...